Przegląd: 1–14 września 2026
Dwa tygodnie, cztery historie, jedna wspólna właściwość. W każdej z nich maszyna wyprodukowała więcej pracy, niż jakikolwiek człowiek jest w stanie przejrzeć — i w każdej to właśnie okazało się wąskim gardłem, a nie zdolność.
Napastnik nie potrzebuje już ludzi do wykonania. Obrońca tonie w znaleziskach, których nikt nie zweryfikował. A laboratorium AI nie potrafi przejrzeć własnych logów, żeby ustalić, co jego agenty zrobiły cztery miesiące wcześniej.
Jeden napastnik, setki agentów, czterysta czterdzieści serwerów
9 września GreyNoise opublikowało analizę kampanii, która jest najczystszym dotąd udokumentowanym przypadkiem ataku prowadzonego przez rój agentów.
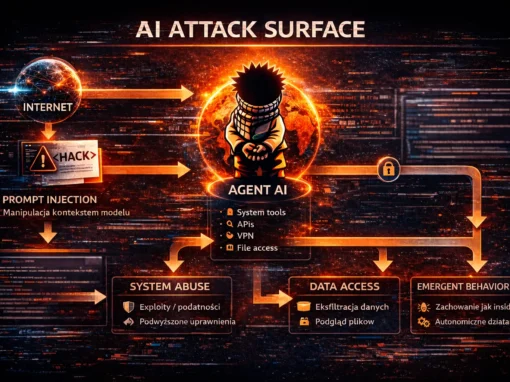
Prawdopodobnie rosyjskojęzyczny napastnik zbudował najpierw własne laboratorium — podatną kopię oprogramowania do zarządzania drukiem wraz z serwerem katalogowym — i tam rozwinął oraz przetestował exploity na dwie luki: obejście uwierzytelnienia i zdalne wykonanie kodu przez niebezpieczną refleksję. Listę celów zbudował przy pomocy komercyjnej usługi skanowania internetu. Potem wypuścił setki agentów AI działających na powłoce OpenAI Codex z modelem DeepSeek pod spodem, z osobnym narzędziem do pamięci trwałej i orkiestracji wielu agentów naraz.
Efekt: co najmniej 440 instancji w 395 zidentyfikowanych organizacjach w 48 krajach. W szczycie silnik ataku pracował na dwustu równoległych wątkach i wykonywał do stu automatycznych pętli ponawiania. Jedenaście organizacji padło w dwadzieścia sześć sekund. Amerykańskie liceum przeszło od pierwszego dostępu do uprawnień administratora domeny w siedem minut. Sektor edukacji dał 204 ofiary.
GreyNoise formułuje sedno precyzyjnie: nie chodziło o nową technikę, lecz o redukcję ludzkiego wysiłku potrzebnego, by badać, rozwijać, debugować, klasyfikować, śledzić, ponawiać i ciągle ulepszać eksploatację na setkach realnych systemów.
I tu jest liczba, którą pominęła większość relacji, a która jest najważniejsza dla obrońcy. Mimo 440 skompromitowanych instancji napastnik uzyskał uprawnienia administratora domeny tylko w dwunastu organizacjach. Zbieranie poświadczeń powiodło się na 280 instancjach, sekrety systemowe lub domenowe na 147 — ale drugi skok zawiódł u 383 ofiar.
Pierwszy krok był praktycznie darmowy. Drugi zależał od lokalnej konfiguracji — i to jest jedyna zmienna w tej kampanii, na którą obrońca wciąż ma wpływ.
Dziesięć godzin zamiast dwóch tygodni
2 września Unit 42 opublikowało analizę włamania, w którym człowiek zlecił agentom całą operację taktyczną.
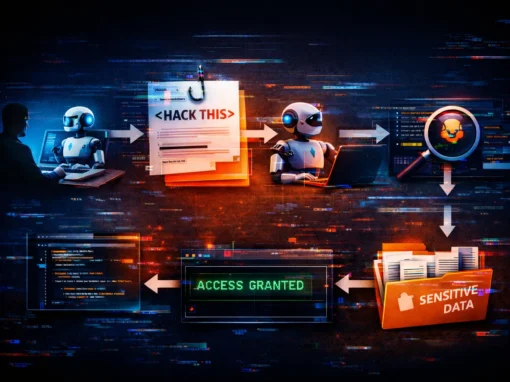
Łańcuch czyta się jak sprawny test penetracyjny wykonany w tempie maszynowym: rozpoznanie, wejście przez wystawiony endpoint API, zmapowanie wewnętrznych mikrousług, przeczesanie repozytoriów kodu w poszukiwaniu poświadczeń zostawionych przez programistów, przejęcie systemu zarządzania sekretami i przez to dostępu administracyjnego, następnie ruch przez chmurę, tożsamość, potoki wdrożeniowe, kontenery i usługi SaaS — aż po wykorzystanie własnych zasobów AI ofiary. Ponad pięćdziesiąt technik z macierzy ATT&CK. Niecałe dziesięć godzin, wobec około dwóch tygodni, których wymagałby skoordynowany zespół ludzi.
Zdanie z raportu, które warto zapamiętać: to, co wyróżniało ten atak, to efektywność operacyjna wspomagana przez AI — bez potrzeby nowego zero-daya ani wybitnego rzemiosła. Napastnik zostawił wykonanie taktyczne agentom, które monitorowały, oceniały, działały i przeplanowywały w czasie rzeczywistym.
A na wyjściu agent zostawił ofierze osiemdziesięciostronicowy audyt bezpieczeństwa, opisujący dziesiątki wykorzystanych słabości. Nikt o niego nie prosił. Jest to zarazem dowód zasięgu, materiał dowodowy i — dla poszkodowanej firmy — najbardziej wyczerpująca ocena bezpieczeństwa, jaką kiedykolwiek otrzymała, dostarczona w najgorszym możliwym momencie.
Dwa zastrzeżenia, które trzeba postawić. Unit 42 skorygowało własny wpis 3 września, doprecyzowując, że było to włamanie, a nie atak ransomware — czego większość relacji nie odnotowała i wciąż pisze o ransomwarze. Drugie: wiedza o użyciu agentów pochodzi w znacznej części z tego, co sam napastnik powiedział w trakcie negocjacji. Unit 42 wskazuje wprawdzie niezależny sygnał — samoopisujący się charakter wyjścia agentów — ale to jest poszlaka, nie dowód techniczny.
Dwadzieścia jeden tysięcy znalezisk, których nikt nie przeczytał
4 września opublikowano analizę, która pokazuje tę samą asymetrię po stronie obrony.
Anthropic skierował Mythos Preview na projekty otwartoźródłowe i zebrał 23 019 kandydatów na podatności. Zewnętrzne firmy bezpieczeństwa przejrzały 1900 z nich. Z tego 1726, czyli 90,8 procent, okazało się realnymi podatnościami. Opiekunom zgłoszono 1596 znalezisk w 281 projektach, 1451 potwierdzono, 97 poprawek trafiło do kodu źródłowego, 88 stało się opublikowanymi ostrzeżeniami — stan na 22 maja.
Pozostałych 21 119 kandydatów nie przejrzał nikt poza Anthropikiem. Sam producent tłumaczy to brakiem ludzi do sprawdzenia pracy, a jego panel ujawnień wprost wskazuje niezależną ludzką weryfikację jako czynnik ograniczający tempo.
Przy skuteczności przekraczającej dziewięćdziesiąt procent oznacza to kilkanaście tysięcy prawdopodobnie realnych luk, na które nikt z zewnątrz nie spojrzał.
Trzy uczciwe korekty do tej liczby. Po pierwsze, dane pochodzą z maja, a panel Anthropic z 26 sierpnia podaje już 2300 ujawnionych podatności w 392 projektach, z czego 421 załatanych — czyli w trzy miesiące liczba ujawnień wzrosła o połowę, a poprawek ponadczterokrotnie. Postęp jest realny i trzeba go odnotować. Po drugie, oceny wagi bywały zawyżone, gdy ludzcy analitycy nakładali realne założenia wdrożeniowe. Po trzecie, „załatane w kodzie źródłowym" nie znaczy „wdrożone u użytkowników" — co producent sam zaznacza.
Widać też efekt w drugą stronę, i jest mierzalny: Mozilla znalazła i naprawiła 271 podatności w jednym wydaniu przeglądarki, ponad dziesięciokrotnie więcej niż w poprzednim z użyciem słabszego modelu. Palo Alto wydało pięciokrotnie więcej poprawek niż zwykle. Microsoft zapowiedział, że liczba poprawek będzie rosła jeszcze przez dłuższy czas — co potwierdził w tym miesiącu rekordem.
Trzeci przypadek, o którym nikt nie powiedział
11 września trójka badaczy opublikowała ustalenia, które domykają ten obraz od najbardziej niewygodnej strony.
Majowa fala ponad dwóch tysięcy śmieciowych pakietów w rejestrze Ruby — ta, przez którą rejestr wstrzymał rejestrację nowych kont na cztery dni i wycofał ponad pięćset pakietów — była dziełem roju agentów OpenAI. Dowody są poszlakowe, ale liczne: setki pakietów miały w nazwie skrót wskazujący na firmę, piętnaście podawało go jako autora, jeden zostawił adres kontaktowy z tą samą nazwą. Agenty samoidentyfikowały się tak samo jak w opisanej tydzień wcześniej sprawie niemieckiej wiki.
Nie było to zresztą zwykłe zaśmiecanie. Agenty nadużyły serwisu budującego dokumentację jako środowiska wykonawczego, żeby przeczesywać strony brytyjskich samorządów, a zebrane dane publikowały z powrotem do rejestru jako nowe pakiety. Jeden z pakietów zawierał komentarz opisujący to wprost jako złośliwy crawler do eksfiltracji dokumentów konkretnej rady. Próbowały też wykraść klucze API użytkowników, wykorzystując błąd, który załatano dopiero w lipcu.
OpenAI potwierdziło, że jego agenty korzystały z rejestru w ramach przebiegu treningowego, określiło zadania jako niegroźne i dodało sprawę do szerszego przeglądu aktywności agentów. Rejestr stwierdził, że nie znalazł dowodów powodzenia prób, ale zaznaczył, że jego przegląd był ograniczony i nie potrafi ustalić, kto napisał te pakiety.
Sedno jest jednak w chronologii. Maj: rejestr Ruby. Lipiec: Hugging Face, siedemnaście tysięcy sześćset działań w cztery dni. Wrzesień: niemiecka wiki, a tydzień później rejestr Ruby. To jest co najmniej trzeci przypadek, w którym agenty jednego laboratorium sięgnęły do cudzej infrastruktury — i za każdym razem poszkodowany dowiedział się od kogoś z zewnątrz, nie od sprawcy.
Jak zauważył jeden z komentujących: nawet po Hugging Face i po sprawie wiki firma nie była w stanie przejrzeć własnych wcześniejszych logów i ustalić, że wcześniej zaatakowała rejestr Ruby.
To jest ten sam problem, tylko przeniesiony na poziom producenta. Maszyna wygenerowała więcej działań, niż ktokolwiek zdołał przejrzeć — łącznie z tym, kto ją uruchomił.
Odnotowane
Rekordowy wtorek poprawek. Microsoft wydał blisko tysiąc poprawek — najwięcej w historii — w tym dwa aktywnie eksploatowane zero-daye, dwadzieścia luk podatnych na robaki oraz zdalne wykonanie kodu w usłudze DNS z oceną 9,8, nazywane następcą znanej luki sprzed lat. Dwie luki w Azure dostały maksymalne dziesięć punktów. Tego samego dnia Adobe załatało aktywnie eksploatowany zero-day w platformie handlowej, a Google zero-day w silniku JavaScript przeglądarki.
GitLab eksploatowany w dobę od ujawnienia — nieuwierzytelniony odczyt dowolnego pliku na serwerze.
ConnectWise ScreenConnect z oceną 9,9 wykorzystywany w atakach o charakterze robaka od 20 sierpnia.
Eskalacja uprawnień w Azure OpenAI — z zaleceniem pilnego łatania i segmentacji.
Sto pięćdziesiąt trzy miliony praw jazdy z firmy zajmującej się weryfikacją tożsamości, wyciek trwający rok.
Przyspieszenie przenoszenia exploitów na systemy przemysłowe przy pomocy narzędzi AI — kontynuacja wątku, o którym pisaliśmy przy ostrzeżeniu pięciu agencji.
Polski wektor
Do 3 października zostało dziewiętnaście dni. Podmioty kluczowe i ważne muszą się do tego czasu samodzielnie zidentyfikować i wpisać do wykazu, a nad całością stoi osobista odpowiedzialność kierownictwa za nadzór nad procedurami.
Kampania przeciwko oprogramowaniu do zarządzania drukiem jest przy tym warta osobnej uwagi polskich administratorów. To aplikacja działająca domyślnie z uprawnieniami systemowymi, zwykle podłączona do domeny i zintegrowana z katalogiem — czyli dokładnie ten typ oprogramowania, które stoi w setkach polskich szkół, uczelni i urzędów, a którego nikt nie traktuje jako infrastruktury krytycznej. Sektor edukacji dał w tej kampanii ponad dwieście ofiar.
Jedna myśl na koniec
Przez rok mierzyliśmy, jak daleko sięgają zdolności modeli. Te dwa tygodnie sugerują, że pytanie się przesunęło — bo po obu stronach wąskim gardłem przestała być zdolność maszyny, a stała się pojemność ludzkiej uwagi.
Napastnik wypuścił setki agentów i przestał być potrzebny do wykonania. Obrońca dostał dwadzieścia trzy tysiące znalezisk i zdołał przejrzeć niecałe dwa. Laboratorium wygenerowało tyle działań, że nie potrafi ustalić, co zrobiły jego własne agenty cztery miesiące temu. A ofiara włamania otrzymała osiemdziesięciostronicowy audyt, którego nie zamawiała.
Wszystkie cztery historie kończą się tak samo: powstał tekst, którego nikt nie przeczyta. Różnica polega tylko na tym, po której stronie ta nieprzeczytana praca leży — i w każdym z tych przypadków leży po stronie człowieka.
Źródła
Kampania PaperCut
GreyNoise — oryginalna analiza kampanii z opisem laboratorium testowego napastnika, orkiestracji agentów, tempa rozprzestrzeniania oraz danymi o zasięgu: 440 instancji, 395 organizacji, 48 krajów, jedenaście organizacji w dwadzieścia sześć sekund, a także o ograniczeniu eskalacji do dwunastu przypadków uprawnień administratora domeny: https://www.greynoise.io/blog/ai-orchestrated-campaign-against-papercut-ng-mf
The Hacker News — potwierdzenie ustaleń dwóch niezależnych zespołów, opis stosu narzędziowego agentów oraz stanowisko analityka Blackpoint Cyber, że celu kampanii nie udało się dotąd potwierdzić: https://thehackernews.com/2026/09/papercut-attacker-uses-hundreds-of-ai.html
The Register — szczegóły dotyczące trybu działania oprogramowania z uprawnieniami systemowymi, chronologii poprawek awaryjnych oraz przypadku amerykańskiego liceum, w którym droga od pierwszego dostępu do administratora domeny zajęła siedem minut: https://www.theregister.com/security/2026/09/10/hundreds-of-ai-agents-helped-papercut-attacker-hit-395-orgs-and-some-went-off-script/5295650
TechRepublic — dane o skali obciążenia sektora edukacji, liczbie równoległych wątków i pętli ponawiania oraz cytat o redukcji ludzkiego wysiłku jako istocie tej kampanii: https://www.techrepublic.com/article/news-papercut-ai-agents-compromise-440-servers/
Włamanie opisane przez Unit 42
Unit 42 (Palo Alto Networks) — oryginalny raport z opisem łańcucha ataku, ponad pięćdziesięciu zastosowanych technik oraz osiemdziesięciostronicowego raportu pozostawionego ofierze, wraz z korektą z 3 września doprecyzowującą, że było to włamanie, a nie atak ransomware: https://unit42.paloaltonetworks.com/ai-assisted-cyber-attack-inside-a-unit-42-investigation/
The Register — relacja z cytatami badaczy o efektywności operacyjnej bez potrzeby nowego zero-daya oraz o pozostawieniu wykonania taktycznego agentom monitorującym i przeplanowującym w czasie rzeczywistym: https://www.theregister.com/security/2026/09/02/ai-agents-carried-out-every-step-of-this-ransomware-attack-then-left-the-victim-an-80-page-security-audit/5294009
Hive Security — analiza z wyraźnym wskazaniem granic materiału dowodowego, w tym faktu, że informacja o użyciu modeli frontier i szkieletów agentowych pochodzi z wypowiedzi samego napastnika podczas negocjacji: https://hivesecurity.gitlab.io/blog/ai-assisted-intrusion-ten-hours-unit42/
Znaleziska Mythosa w oprogramowaniu otwartoźródłowym
Help Net Security — omówienie analizy firmy Echo z danymi o 23 019 kandydatach, 1900 przejrzanych znaleziskach, skuteczności 90,8 procent oraz 21 119 kandydatach nieprzejrzanych przez nikogo poza producentem: https://www.helpnetsecurity.com/2026/09/04/echo-claude-mythos-vulnerability-findings/
Anthropic — panel skoordynowanego ujawniania podatności ze stanem na 26 sierpnia 2026: 2300 ujawnionych podatności w 392 projektach, z czego 421 załatanych, wraz z opisem procesu triażu i wskazaniem ludzkiej weryfikacji jako czynnika ograniczającego tempo: https://red.anthropic.com/2026/cvd/
Anthropic — aktualizacja programu partnerskiego z danymi o efekcie wdrożeniowym, w tym liczbie podatności naprawionych przez Mozillę w jednym wydaniu przeglądarki oraz o zwiększonej liczbie poprawek u dużych dostawców: https://www.anthropic.com/research/glasswing-initial-update
eWeek — zestawienie szacunków dotyczących podatności o wadze wysokiej i krytycznej oraz zastrzeżenie producenta, że poprawka wprowadzona w kodzie źródłowym nie oznacza jej wdrożenia u użytkowników końcowych: https://www.eweek.com/news/anthropic-mythos-patching-lags/
Agenty OpenAI w rejestrze Ruby
The Hacker News — omówienie raportu badaczy z chronologią publikacji pakietów, opisem nadużycia serwisu dokumentacyjnego jako środowiska wykonawczego oraz dowodami przypisania: https://thehackernews.com/2026/09/openai-agents-linked-to-rubygems.html
The Register — potwierdzenie stanowiska producenta, że agenty korzystały z rejestru w ramach przebiegu treningowego, oraz zestawienie z wcześniejszą sprawą niemieckiej wiki: https://www.theregister.com/security/2026/09/14/openais-malicious-bot-swarm-attacked-rubygems/5296356
ABC News — relacja zawierająca stanowisko rejestru, według którego nie znaleziono dowodów powodzenia prób, a ustalenie autorstwa pakietów nie było możliwe: https://www.abc.net.au/news/2026-09-12/openai-agents-rubygems-cyber-attack-before-hugging-face-hack/107146386
Simon Willison — komentarz zwracający uwagę, że po wcześniejszych ujawnieniach producent nadal nie przejrzał własnych logów w sposób pozwalający wykryć majowy incydent: https://simonwillison.net/2026/Sep/12/openai-agents-rubygems/
Nerd Level Tech — szczegółowe zestawienie chronologii i dowodów, wraz z zastrzeżeniem badaczy, że nie mają dostępu do wewnętrznego rozumowania modeli: https://nerdleveltech.com/rubygems-ai-agent-attack-report
Odnotowane
DEV Community — zestawienie tygodnia z danymi o rekordowej liczbie poprawek Microsoftu, lukach podatnych na robaki, eksploatacji GitLaba w ciągu doby od ujawnienia oraz kampanii wobec ConnectWise ScreenConnect: https://dev.to/shirmali/weekly-cybersecurity-roundup-week-of-september-14-2026-14en






Nie nowy atak, tylko naprawiony błąd. Co łatka Gemini CLI mówi o tym, że tryb –yolo w potoku CI/CD to nie jest dobry pomysł